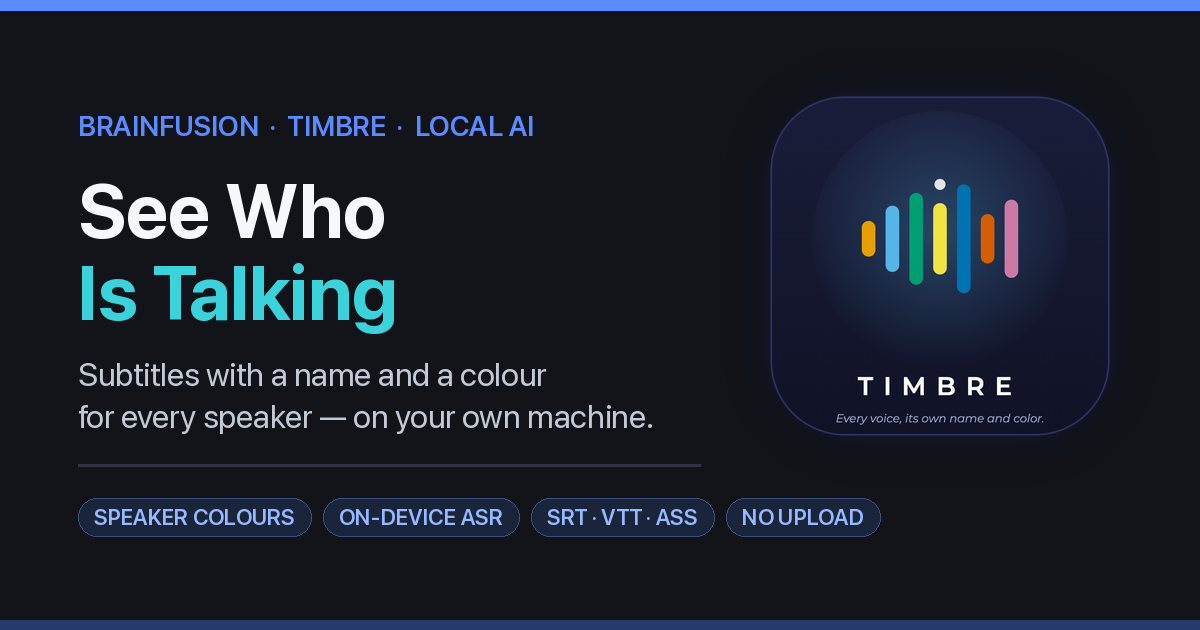
Timbre is bijna klaar: een videospeler die ondertitels maakt waarin je ziet wíe er praat — elke spreker met een eigen naam en een eigen kleur. Het bijzondere zit niet in wat hij doet, maar in wáár hij het doet: op jouw eigen computer. Je video wordt niet geüpload, niet op een server geanalyseerd en niet door iemand anders bewaard. Alleen door jou.
Wat Timbre doet — in gewone taal
Je opent een film, een interview, een lezing of een vergadering. Eén klik, en de ondertitels staan er. Niet als één grijze brei, maar met de naam van de spreker erbij en een eigen kleur per persoon. Je ziet dus meteen wie aan het woord is, zonder terug te spoelen of te gokken.
- Werkt met wat je hebt — mp4, mov, mkv, webm, avi, of alleen de audio (mp3, wav, m4a).
- Herkent de woorden én de stemmen — praten er twee of drie mensen door elkaar, dan haalt Timbre ze uit elkaar.
- Jij bepaalt de namen en de kleuren — en als twee sprekers dezelfde persoon blijken, voeg je ze met één klik samen.
- Tekst aanpassen kan altijd — klik op een regel om een tikfout te herstellen; de timing blijft kloppen.
- Exporteren wat je gewend bent — SRT, VTT of ASS, klaar voor je speler, YouTube of je montagesoftware.
Denk aan de film van een familiefeest, een interview dat je zelf hebt opgenomen, een gastlezing die je wil terugkijken, een podcastaflevering, of je eigen vlogs. Precies dat soort materiaal waar je eigenlijk nooit aan begint, omdat ondertitelen te veel werk is — en waarvan je ook niet wil dat het ergens op een server belandt.
De “gratis” vertaal-app
Vertalen lijkt gratis. Je hebt de app toch al op je telefoon, of je downloadt hem in twee tikken uit de winkel van je fabrikant. Handig, en het werkt echt.
Stel je voor: je staat in het buitenland bij een makelaar, je onderhandelt over de prijs van een huis, en die app vertaalt alles keurig heen en weer. De makelaar noemt een bedrag. Jij knikt, je bedankt, je loopt naar buiten. Het gesprek staat nog in je app — als tekst, als audio, met de prijs erin.
En dan gebeurt dit: je vraagt later aan een chatbot van hetzelfde platform wat de huizenprijzen in die buurt zijn. En het bedrag dat je net met de makelaar besprak, komt naar voren. Niet omdat iemand jou expres volgt, maar omdat jouw gesprek daar eenmaal ligt — en omdat het platform het mag gebruiken. (EULA)
Dat is de rekensom achter “gratis”. Je gegevens zijn het product. Een gesprek waarin iemand een vraag stelt en een ander een prijs noemt, is precies het soort tekst waar een taalmodel iets mee kan: intern, om het model te verbeteren, of als dataset in de handel. Bij dit soort diensten staat in de voorwaarden bijna altijd dat wat je invoert gebruikt mag worden om de dienst te verbeteren. Niemand doet iets stiekems. Het staat er gewoon.
Hetzelfde patroon bij ondertitels
Ondertitels maken gebeurt tegenwoordig op precies dezelfde manier. Je sleept een video naar een online tool, of je laat een platform automatisch ondertitelen. Dat gaat snel, en het is accuraat — daar is geen discussie over. De prijs is alleen dat je audio de deur uit gaat. Bij een lezing is dat misschien geen ramp. Bij een cliënt gesprek, een sollicitatie, een therapiesessie-opname of een familieverhaal is het dat wél. En het blijft daar: het gaat niet weg omdat de video oud is.
Onze Visie: Pentecost en Timbre
Daarom bouwt Brainfusion dit soort dingen zelf, en lokaal.
- Pentecost is onze chat met live vertaling: jij typt in jouw taal, de ander leest het in de zijne. De vertaling draait op onze eigen machines — geen Google Translate, geen tekst die naar een platform gaat. Daar is Pentecost juist voor gebouwd.
- Timbre doet hetzelfde voor ondertitels: de herkenning, het scheiden van de stemmen en het kleuren gebeuren op jouw computer. Wat je opneemt, blijft van jou.
En nee, dat is geen tragere knutselversie. De commerciële diensten zijn snel en nauwkeurig, maar lokale oplossingen zijn inmiddels snel genoeg voor normaal gebruik — soms evenaren ze de commerciële versie. Bij Pentecost merken gebruikers dat dagelijks. Sneller is niet hetzelfde als beter, en het is zeker niet hetzelfde als veiliger.
De technische kant, in het kort
- Spraakherkenning draait lokaal — de taalmotor komt één keer binnen bij de installatie, daarna werkt Timbre zonder internet.
- Sprekerherkenning (diarisatie) is ingebouwd — Timbre bepaalt niet alleen wát er gezegd wordt, maar ook wie het zegt, en kleurt dat per spreker.
- Alles is aan te passen — namen, kleuren, sprekers samenvoegen, losse regels tekst herstellen, en de timing klopt daarna nog steeds.
- Standaard exportformaten — SRT, VTT en ASS, dus je hoeft je workflow niet om te gooien.
- macOS en Linux — dezelfde code, hetzelfde gedrag. Op een Mac met Apple Silicon gaat een lange opname in enkele minuten tot een kwartier, afhankelijk van het model.
- Geen account, geen abonnement, geen upload — en dus ook geen teller die per minuut doorloopt.
Eerlijk is eerlijk: Timbre is nog niet af. De macOS-versie werkt, de Linux-versie is gebouwd en getest, en er zijn nog scherpe randjes — hele lange opnames vragen op een lichtere machine meer geduld, en er is nog geen publieke download met installatieprogramma.
Wat het jou oplevert
Persoonlijk: je kan eindelijk dat familiearchief, die lezing of dat interview ondertitelen zonder je bestand aan een onbekende te geven. Het werkt ook zonder internet — in de trein, op een locatie, in het vliegtuig.
Zakelijk: je hebt geen verwerker overeenkomst nodig met een leverancier in een ander land, want er is geen leverancier die je materiaal ziet. Er gaat niets naar buiten de EU, want er gaat niets naar buiten je eigen computer. En er is niemand die je bestand kan weigeren, verwijderen of tegen betaling teruggeven — dat is niet theoretisch: bij een van onze eigen boekprojecten weigerde een platform beleefd om een bepaalde verwijzing op te nemen. Een bestand dat bij een platform ligt, is een bestand dat het platform kan weigeren.
Over de namen, zodat je niet zoekt
De app heet Timbre. De pagina waar je er meer over leest, staat op deze site onder de naam MyVideo — die naam gebruiken we in het menu. In dit artikel heb ik het steeds over Timbre, want dat is de merknaam van de app. Zelfde ding, twee namen. Sorry voor de verwarring; dat is het gevolg van een productnaam die langer meegaat dan de merknaam eronder.
Status: in ontwikkeling, komt snel
Timbre is in ontwikkeling en komt snel. Er is op dit moment geen publieke download. Wie al mee wil kijken met een vroeg, privé voorbeeld (als beta tester)— of een specifiek soort opname (of taal) wil laten meenemen — kan dat laten weten via het contactformulier. Meer over de app staat op de MyVideo-pagina.
Eerdere posts in deze reeks: Gooi het even in ChatGPT · Hoe je AI kan gebruiken? · Stel dat je je eigen AI-coder lokaal draait
Blijf in gesprek
Ook op Telegram
Nieuwe posts, korte notities en wat er speelt — in het Brainfusion-kanaal op Telegram. Volg @Brainfusion →